
在昨天完成Dev-Advisor的雙軌分類分流後,系統已經具備區分內部規範與外部技術問題的能力,然而下半部的一般技術諮詢分支如果僅仰賴大語言模型自帶的預訓練記憶,遇到最新釋出的版本或即時技術更新時便會產生知識盲區。
今天的核心目標是在一般諮詢路徑中引入「聯網搜尋(Web Search)」機制,讓系統能即時檢索公開網路資訊,完成端到端的動態技術諮詢。
一、 工作流重組與檢索節點配置
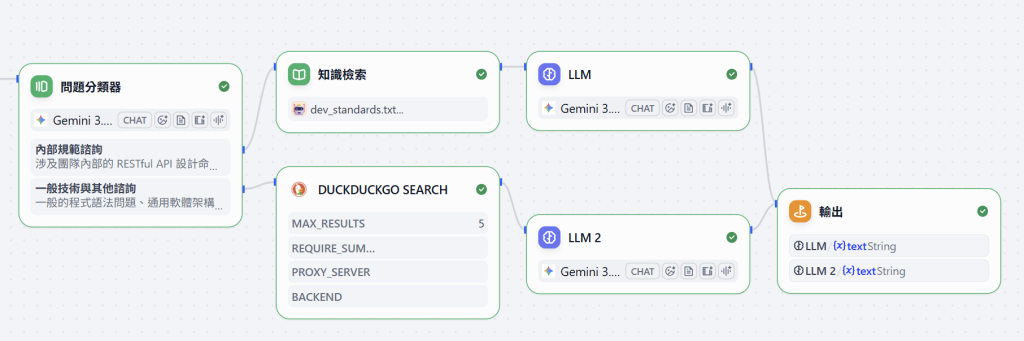
為了賦予分支即時查網頁的能力,我對一般諮詢路徑進行了管線重構:
引入DuckDuckGo Search工具:考量到測試便利性與環境整潔度,採用無須繁複註冊API Key的DuckDuckGo作為檢索來源
節點拓撲調整:將管線從原本的「分類器 -> LLM 2」拆解並插入檢索層,重組為「問題分類器」->「DuckDuckGo Search」->「LLM 2」的依序傳遞架構
資料流對接與Prompt強化:
二、 實作中的工程挑戰與踩坑紀錄
在整條管線落地的過程中,依序排除了三項關鍵技術瓶頸:
變數作用域與連線相依性
剛建立搜尋節點時,在設定面板的變數清單中找不到開始節點的query。隨後理解到Dify畫布的拓撲依賴:必須先將上游節點的連線接入,下游節點才能解析並承接其輸出資料。連線接通後變數即正常顯示。
平台預設配額耗盡(Quota Exceeded)
在連續測試時遭遇了Insufficient credits與OpenAI quota exceeded報錯,由於平台自帶的試用額度有限,難以支撐多輪調試,我決定跳出依賴平台額度的模式,前往Google AI Studio申請個人API Key,並在Dify的「集成 -> 模型供應商」中完成配置,徹底解決了模型配額瓶頸。
模型版本更迭與負載調適
在接入個人 Google 憑證後,先後遇到 Gemini Flash Latest 伺服器尖峰負載(503 Unavailable)以及舊版 API 棄用(404 Not Found 提示 models/gemini-2.5-flash 下線)。依照官方推薦,我迅速將分類器與 LLM 節點統一升級至推薦的 Gemini 3.6 Flash,成功建立起高可用且零成本的模型運算基底。
三、 實測產出與檢索成效觀察
解決所有環境與連線問題後,針對時效性問題進行了檢索測試:
【測試提問】
請查一下目前 Python 最新穩定版本(Stable Release)是哪一版?有哪些主要亮點?
【產出成果】
管線順利完成端到端調用,並產出帶有2026年即時時間戳記的技術摘要,相較於先前回答退回2023年Python 3.12 的狀況,這次的回覆明確證明模型已經嚴格遵照搜尋節點回傳的Context進行彙整,不再使用訓練截止日前的舊記憶。
同時我也觀察到,由於使用者的原始輸入較為口語,直接丟給搜尋引擎容易抓到特定SDK或框架的Release Notes。這讓我認識到「檢索前查詢改寫(Query Rewrite)」在進階工作流中的必要性。
四、 今日成果
今天不僅完成了DuckDuckGo外部檢索節點的串聯與變數傳遞,更自主打通了Google AI Studio的金鑰整合,為整個專案換上了穩定、長期的運算底座。


 iThome鐵人賽
 看影片追技術